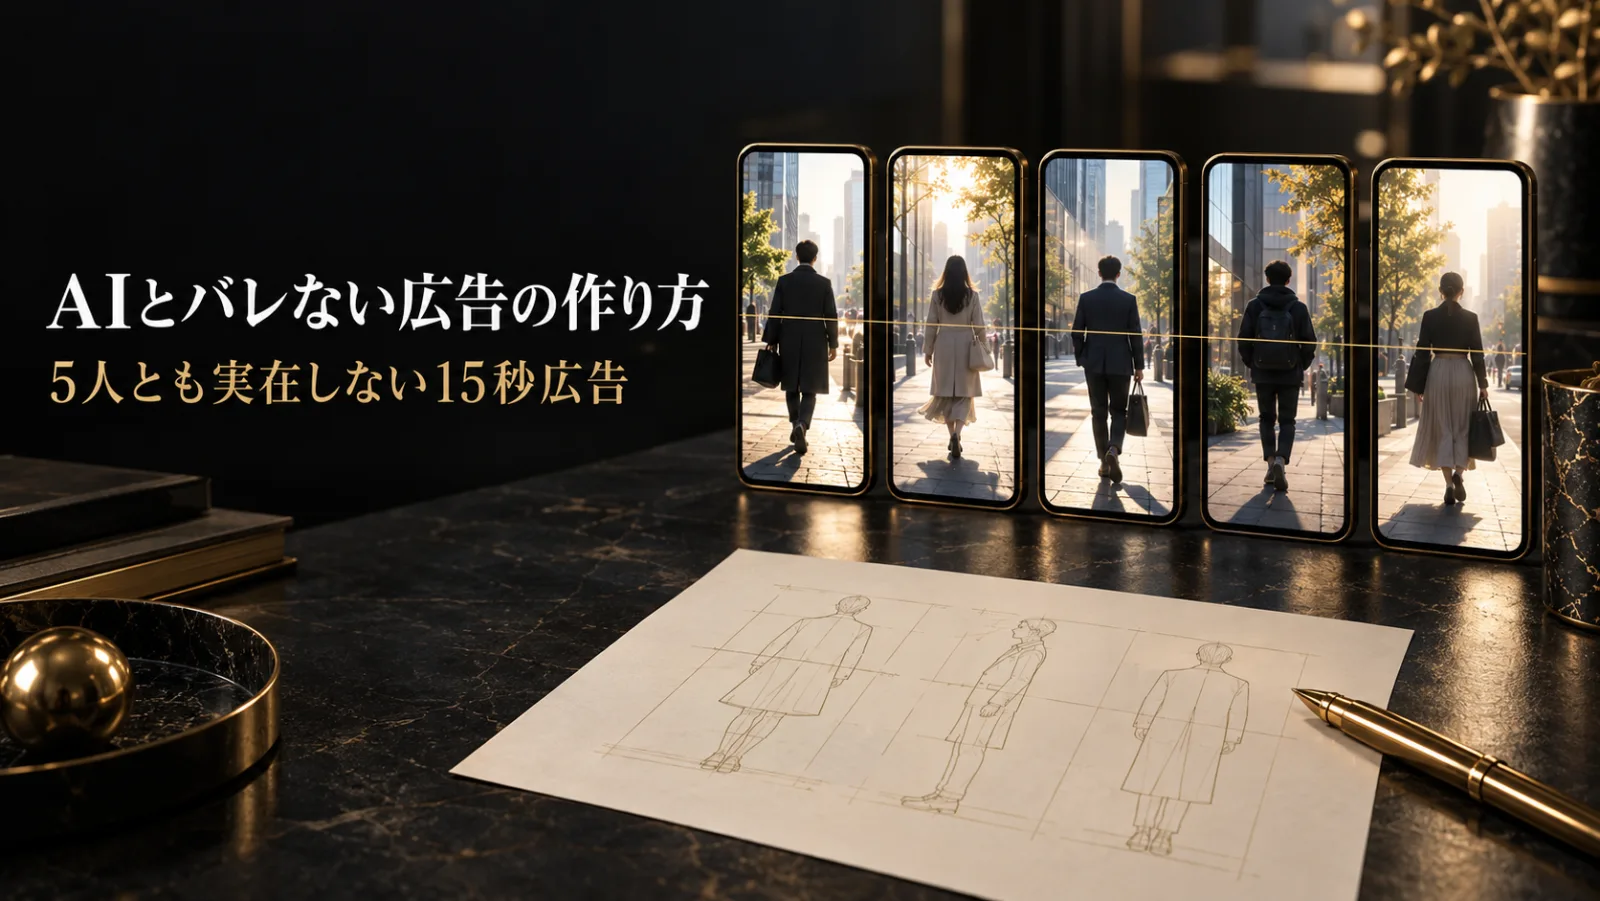
この動画の冒頭に出てくる15秒の広告には、サンフランシスコ・パリ・ドバイ・東京・上海の5人が登場します。5人とも実在しません。人も、街も、声も、AIで作りました。どの街にも行っておらず、カメラも回していません。
この記事では、Masayume がこの広告を作った手順を、動画の内容に沿ってまとめます。AIの動画が「AIっぽく」見える原因と、それを消すための3つのルール、さらに5人の顔の位置と大きさをそろえた方法まで、順番に紹介します。
この動画で分かること
- AIの動画が「AIっぽく」見える3つの原因と、それぞれに効くルール
- 三面図は「顔は1か所だけ」にする理由と、今の三面図の形
- 人物と街を1枚に合成した開始フレームから動かすと、光がなじむ理由
- セリフを秒と読み方まで書く、動画のプロンプトの書き方
- 灰色の人形を使って、5人の顔の位置と動くタイミングをそろえる方法
AIっぽさの正体は3つ
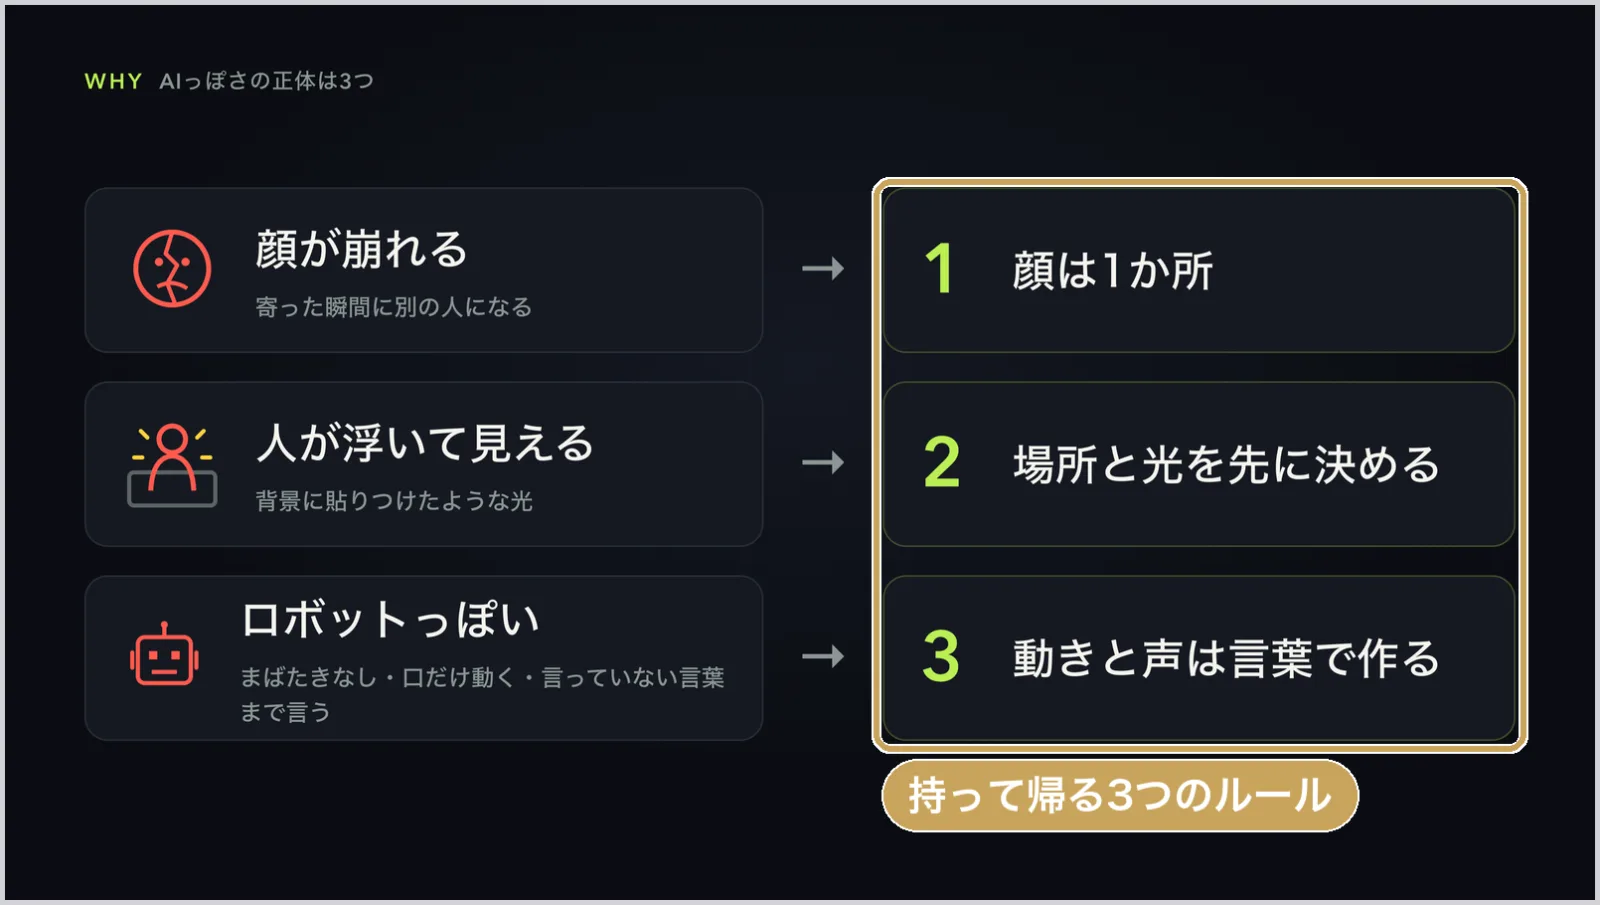
Masayume がこれまで見てきた中で、AIの動画が「AIだな」と分かってしまう原因は、大きく3つあります。
- 顔が崩れる:最初は同じ人なのに、カメラが寄った瞬間に別の人になる
- 人が浮いて見える:人だけ別の照明で撮って、背景に貼りつけたように見える
- 動きと声がロボットっぽい:まばたきがない、口だけ動く、言っていない言葉まで言う
差が出るのは、センスではなく、作る順番とルールです。3つのルールは、この3つの症状に1つずつ効きます。
使った道具
動画で使った道具は4つと、仕上げが1つです(2026年10月時点)。
| 役割 | 道具 | ポイント |
|---|---|---|
| プロンプトを書く | Claude | 英語のプロンプトを自分で書かなくてよい |
| 人物の画像 | Higgsfield の Soul Cinema | 肌や影のリアルさを重視した画像生成 |
| 画像の直しと合成(街の背景も) | Seedream 5.0 Pro | 元の光や質感を残したまま、一部だけ直せる |
| 動かす(セリフの声も) | Seedance 2.5 | 動画とセリフの声を一緒に作れる |
| 仕上げ | After Effects | 人の入れ替え・文字・図解を組む |
進め方の考え方は「人物と場所の画像はたくさん出して選び、時間とクレジットがかかる動画は、狙いを決めてから出す」です。
ルール1:顔は1か所だけ
三面図の中に顔が2つ以上あると、AIが迷う
人物を動画にするとき、AIには「この人です」という参照画像を渡します。よく使うのが、同じ人を前・横・後ろから並べた三面図です。
ここに落とし穴があります。三面図の中に顔が2つ、3つあると、AIはどの顔を見ればよいか迷います。特に危ないのは、遠くから撮る引きの絵です。AIが三面図の中の小さい方の顔を拾い、カメラが寄った瞬間に顔が崩れることがあります。今回の広告のように、遠くから歩いてきて最後に顔のアップになる動画は、まさにこれが起きやすい形です。
Masayume は以前、講義で「正面の全身は入れない方がいい」と話していました。その後、Higgsfield の公式の作り方を確かめると、正面の全身は入っていて、体のパネルを首から下で切っていました。問題は正面ではなく、顔が2つ以上あることでした。
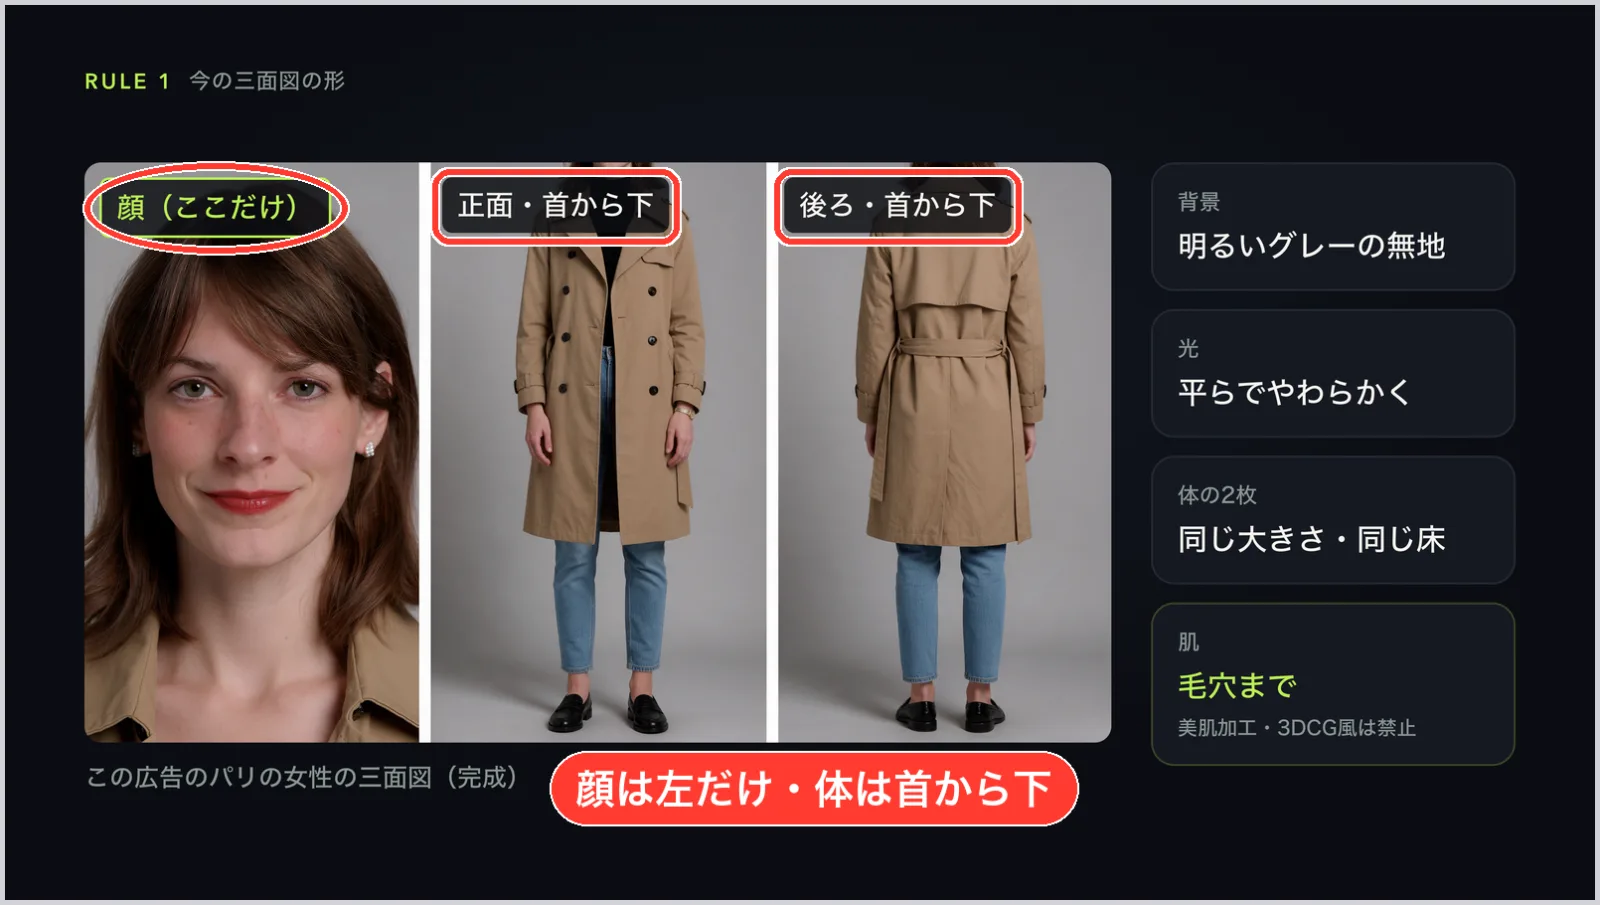
今の三面図の形
- 左:顔のアップ(正面で、両耳が見えるくらい)
- 真ん中:正面の全身(首から下)
- 右:後ろ姿の全身(首から下)
- 背景は明るいグレーの無地。光は平らでやわらかく、強い影はつけない
- 肌は「毛穴が見える自然な肌」と書き、プラスチックのような肌・美肌加工・3DCGのような見た目は禁止と書く
三面図は人物の説明書なので、雰囲気はいりません。
Claude には、この形を書いたテンプレートを先に渡しておきます。そうすると「パリの女性の三面図を作って」の一言で、毎回同じ形のプロンプトが返ってきます。
1回目は4人とも頭が入った
Soul Cinema で4人分を出したところ、「首から下」と頼んだのに、8枚の体のパネルすべてに頭が入りました。公式の作り方でも同じ失敗が出ており、1回目はだいたいこうなります。
そこで、出したらすぐに次の4つを点検します。
- 肌が、つるつるすぎないか
- 光が、強すぎないか
- 顔に、変な点やシミがないか
- 頭の切れ方(体のパネルが首から下になっているか)
直し方は、よく出ていた左の顔のパネルだけを切り抜き、それを参照にして Seedream で三面図を作り直す方法です。Seedream に「首から下で切って」と直してもらうだけでは、首の切れる位置がほとんど動かなかったため、最初から作り直す方を選びました。東京の男性は、動画で揺れて崩れやすいピアスも外しています。1回で決まらないのが普通なので、「出す・点検する・直す」までを1セットと考えます。
ルール2:場所と光を、先に決める
人と場所を別々に作ると、光が浮く
光の浮きは、人と場所を別々に作って、最後に「この人をここに置いて」とAIに任せるから起きます。実写の撮影でも、カメラを回す前に照明と立つ位置を決めます。AIでも同じです。
まず、5つの街の背景を作りました。それぞれ2枚ずつ出して1枚を選び、次の3つを決めています。
- 名所の塔は出さない:広告で使うときにルールがある建物もあり、AIだと形も崩れやすいため。建物の様式や並木で、どの街か分かるようにしました
- 動きに合わせて作る:人が歩いてくる広告なので、どの街も歩道がまっすぐ奥へ伸びる形にしました
- 光の向きをそろえる:5つの街とも、朝の日差しが右から当たるようにしました。人が入れ替わっても、光の向きが変わりません
人物と街を合成した「開始フレーム」から動かす
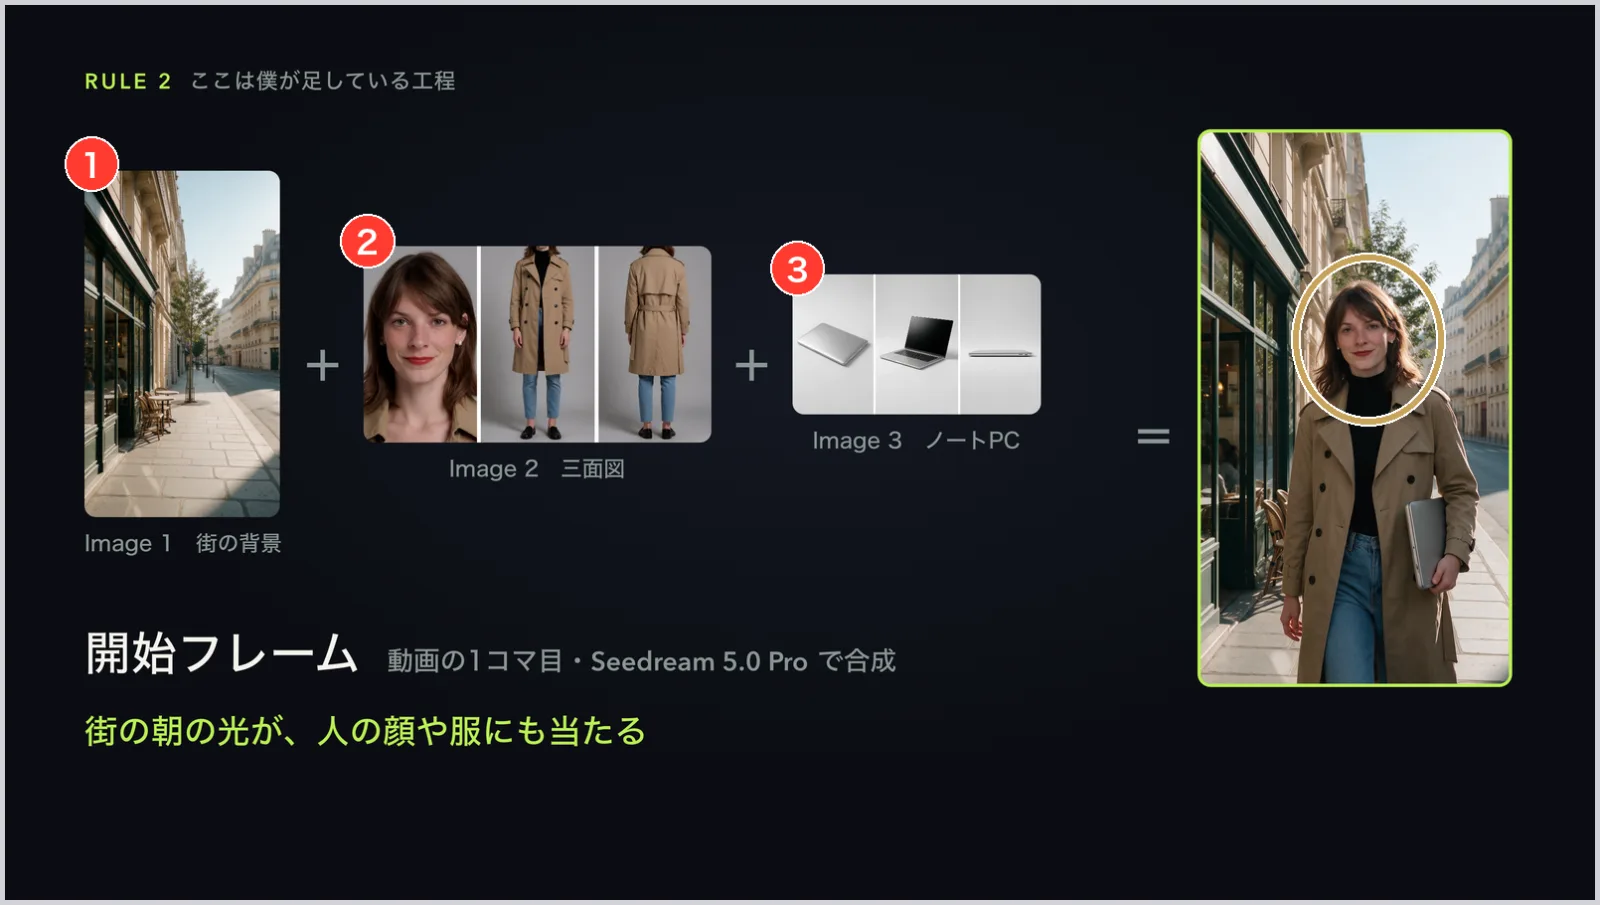
ここが、Masayume が足している工程です。三面図の人物と作った街を、Seedream 5.0 Pro で1枚の絵に合成し、動画の1コマ目にします。入れる画像は、街の背景・三面図・5人が持っている同じノートパソコンの3枚です。
こうすると、街の朝の光が、人の顔や服にもきちんと当たります。この光のなじみが、AIっぽさを消すいちばんの近道だと Masayume は考えています。
合成のプロンプトに書く4つ
- 背景の画像は変えない:カメラの位置も、建物も、そのまま
- 三面図の役割を書く:顔は左のパネルだけ、真ん中と右は体と服。三面図の白い線やグレーの背景は持ち込まない
- 立つ位置と持ち方:歩道の真ん中を歩いてくる、ひざの上から入る距離、ノートパソコンは左わきに抱える。そして「目の高さは画面の上から3分の1」。この1文で、5人の顔の高さをそろえています
- 光と色を街に合わせる:右から差す朝の日差しが顔と肩の右側に当たり、反対側はやわらかい影。白の色味や粒の感じまで背景の写真にそろえ、切り抜いて貼ったような見た目と縁の光は禁止と書く
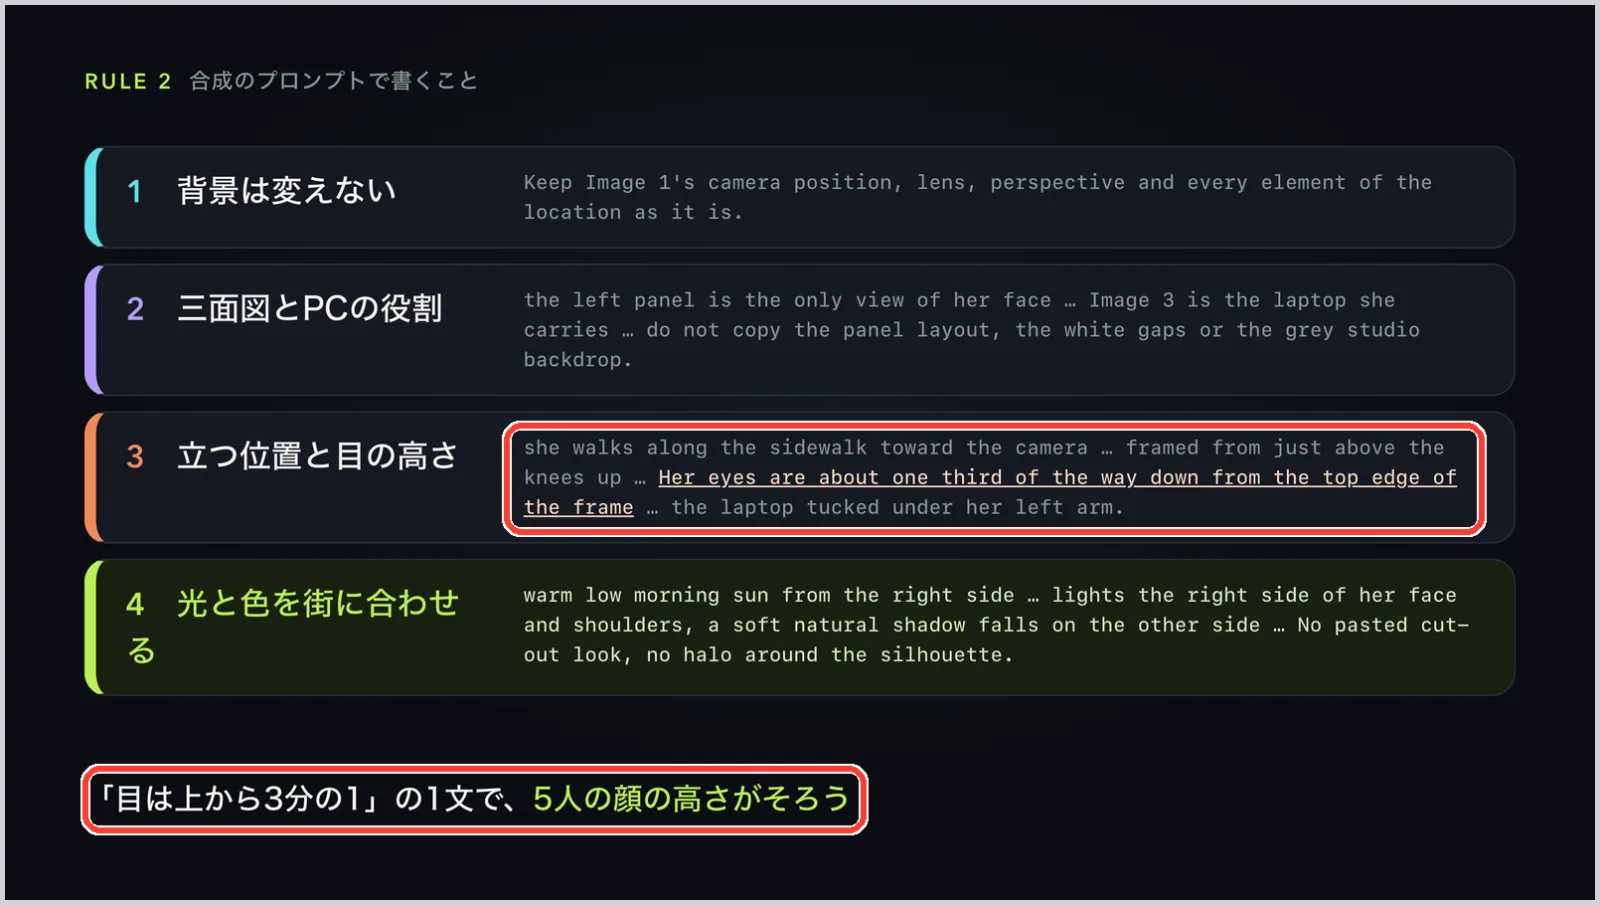
注意が2つあります。
- 画像の番号と入れる順番を合わせる:プロンプトで Image 1 は背景、Image 2 は三面図、Image 3 はノートパソコン、と書いたら、画像を入れる順番もそれに合わせます。ずれると、人の写真で街を作ろうとして、おかしな絵になります
- スクショではなく、生成した元の画像を渡す:スクショだと画質が落ちて、顔が崩れます
開始フレームも2枚ずつ出して選びます。パリは、ノートパソコンを腰の高さで持っていて、サンフランシスコの男性と同じ持ち方の方を選びました。5人に同じ動きをさせるときは、こうした所までそろえておくと、あとが楽になります。
ルール3:動きと声は、言葉で作る
開始フレームと三面図を Seedance 2.5 に入れて、動画のプロンプトを書きます。これも Claude に書いてもらいます。設定は15秒・縦の9:16・720p で、ビットレートを「High」にします。値段は変わらないのに、画質が大きく上がる設定です。最初のサンフランシスコの男性はこれを付け忘れて、画質が低く見えました。
プロンプトの中身で大事なのは、次の3つです。
- 人物の固定:参照画像を付けるだけでなく、髪型や服、ノートパソコンまで文字でも書き込みます。画像と文字の両方で、同じ人だと念を押します
- セリフを秒で書く:「0秒から2.1秒で1行目、2.2秒から4.5秒で2行目」のように、5行ぜんぶの秒を決めます。それぞれ1回だけ言い、ほかの言葉は言わない、と書きます。読み方も書きます。上海の女性は「自動編集」が「自動へんせい」に聞こえたため、次のパリからは「ジドウヘンシュウと読む。ヘンセイではない」とローマ字で書き足し、正しく読めるようになりました
- 人の動き:歩くときは、ひざを曲げ、肩と腰が自然に揺れる。まばたきと呼吸。そしてキーワードで手を動かします(「結果が出る動画」で手のひらを見せる、「たった1本」で指を1本立てる、最後は止まって下を指す)。書かないと、マネキンのように固まったり、すべるように歩いたりします
声については、講義では「長くつなぐなら、先に ElevenLabs で声を作って入れる」と話していました。今回それも試しましたが、声を参照で渡しても、Seedance は声を作り直しました。1人15秒の1本なら、Seedance にそのまま話させるのがいちばんきれいでした。
そのかわり、言っていない言葉を足すことがあります。ドバイの男性は、台本にない言葉を余分に言いました。5人で区切って使う広告なので、作り直さずに、編集で切っています。
応用:灰色の人形で5人の構図をそろえる
マッチカットで人を入れ替えるには、5人の顔の位置と大きさ、歩く速さ、手を動かす瞬間が、全部そろっている必要があります。
まず、開始フレームの顔をそろえました。Mac に入っている顔を見つける機能で5枚の顔の位置と大きさを測り、サンフランシスコの男性と同じ位置・同じ大きさになるように切り抜いています。ここはクレジットを使いません。
ところが、最初に作った上海の女性は、開始フレームどおりに始まりませんでした。全身が見える遠くから歩いてきて、最後に胸から上になり、顔の大きさはサンフランシスコの男性の8割くらいでした。開始フレームを渡しても、毎回そのとおりに始まるわけではありません。
そこで作ったのが、灰色の人形の動画です。サンフランシスコの男性の動画から、人を灰色のシルエットに置き換え、背景はぼかして色も薄くしました。顔も服も街も分からず、分かるのはカメラの動きと、人がいる場所と、動くタイミングだけです。最初は全体をぼかすだけにしましたが、それだとメガネや服の形が分かってしまったため、人形にしました。
この人形の動画を参照として Seedance に渡し、プロンプトに分担を書きます。
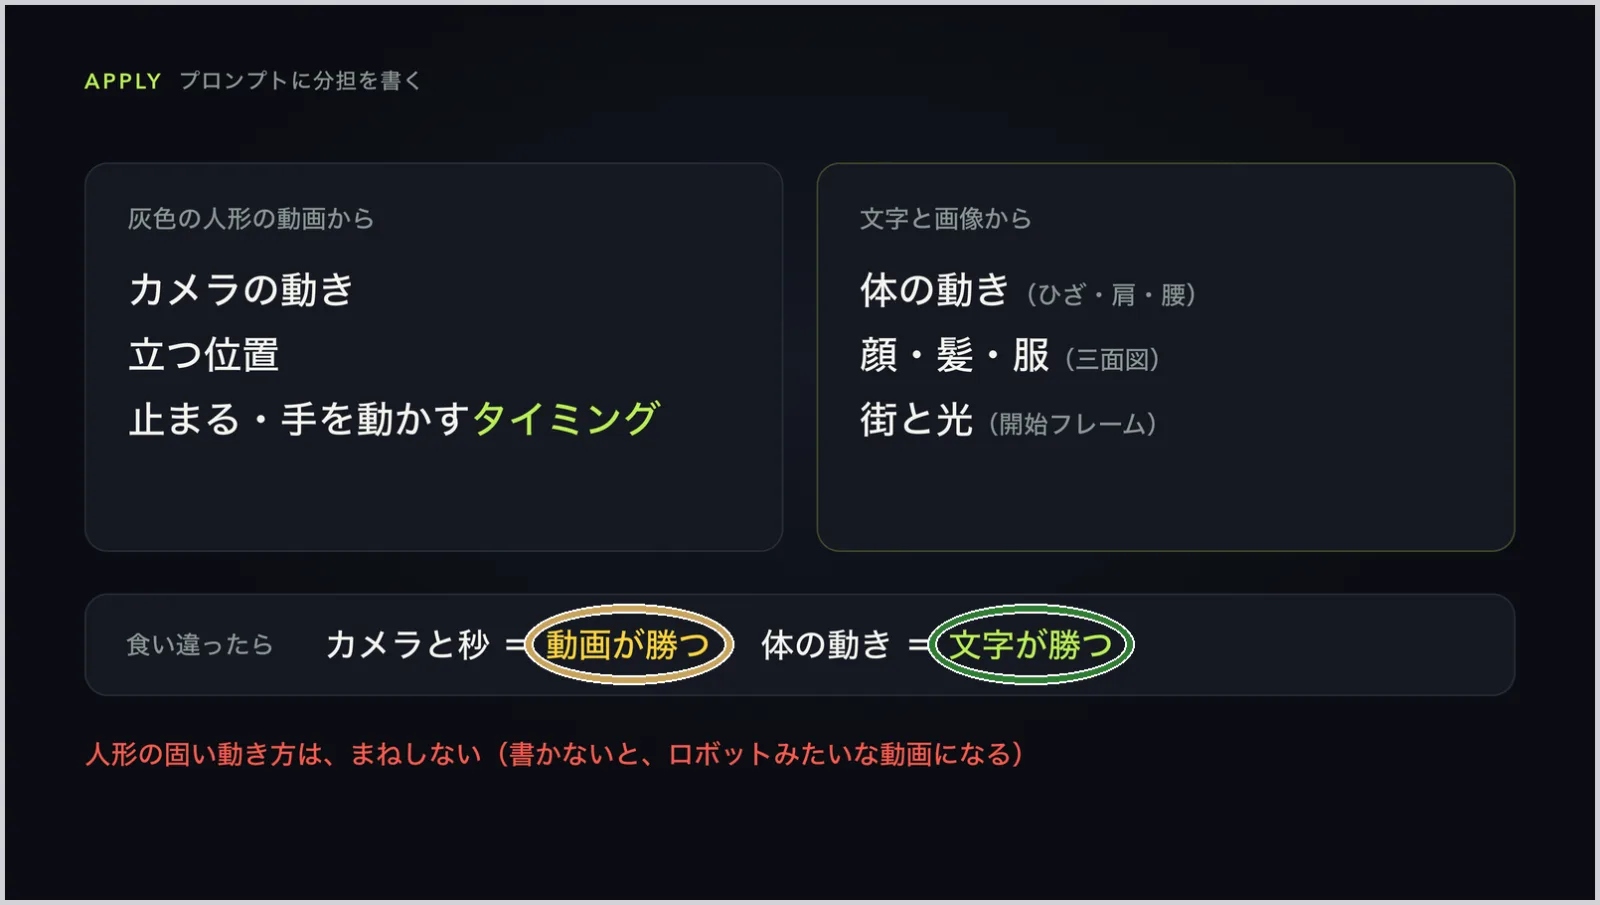
- 動画からもらうのは、カメラの動き・立つ位置・タイミングだけ
- 体の動き・顔・服・街・光は、文字と画像からもらう
- 人形の固い動き方は、まねしない
- 食い違ったら、カメラとタイミングは動画が勝ち、体の動きは文字が勝つ
ここまで書かないと、人形の動きまでコピーされて、ロボットのような動画になります。
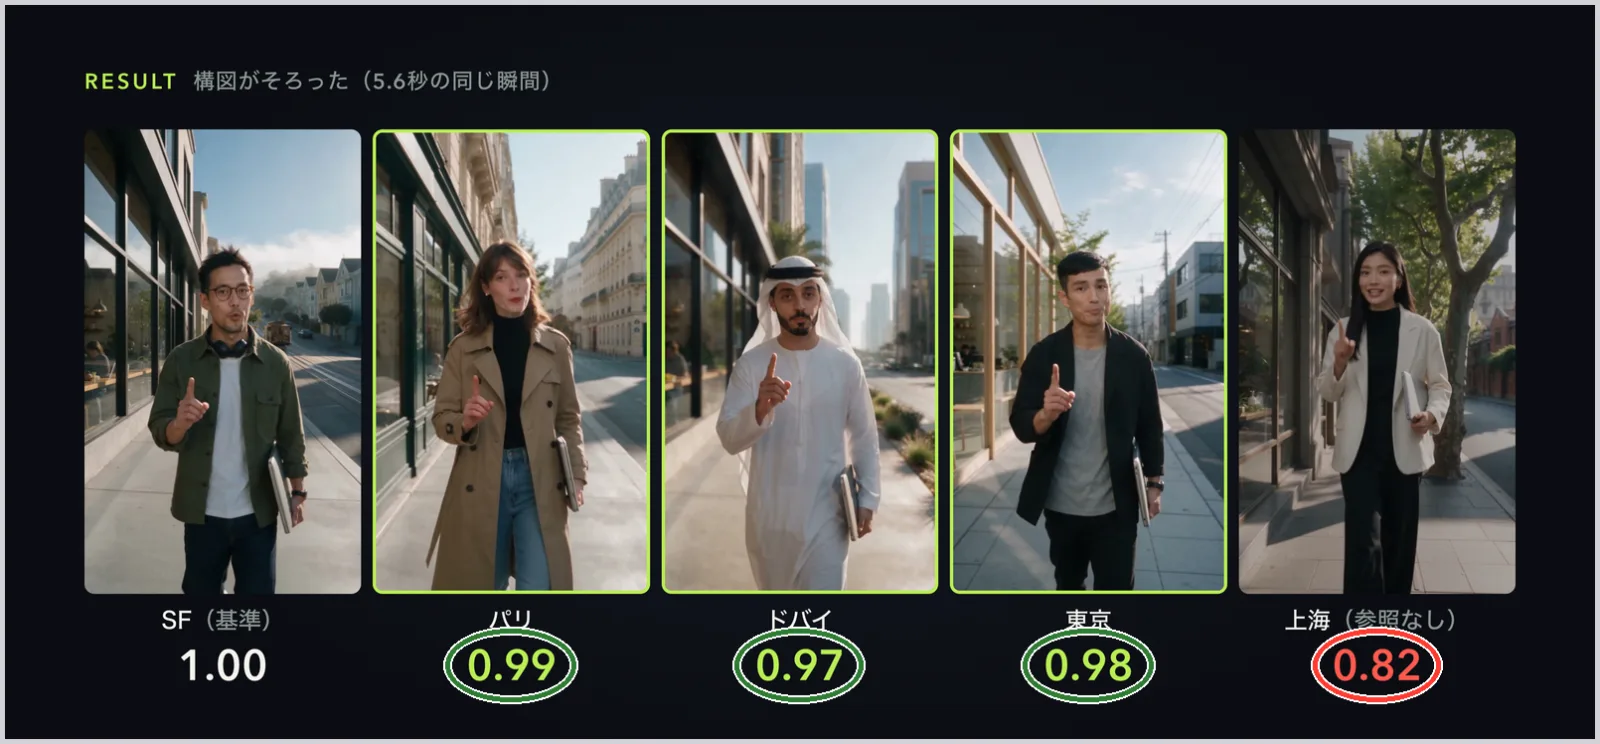
結果、パリ・ドバイ・東京の3人は、顔の大きさがサンフランシスコの男性とほぼ同じになり、指を1本立てる瞬間までそろいました。クレジットは参照なしのときと同じでした。上海の女性だけは、編集で少し拡大して合わせています。
絵コンテを参照に入れるときも、考え方は同じです。顔を描かない線画にします。写真のような絵コンテを入れると、中の顔が2つ目、3つ目の顔になってしまいます。ルール1と同じ理由です。
仕上げは After Effects
5人分の15秒の動画ができたら、最後は After Effects で仕上げます。この編集も、Claude に After Effects を動かしてもらって組みました。
- マッチカット:顔の位置がそろっているので、1つのセリフの途中で人が入れ替わっても、つながって見えます
- 背景を交互に変える:東京の男性の後ろには「自動編集」の文字の壁、サンフランシスコの男性の上には本物の YouTube の視聴ページ、上海の女性は丸いアイコンに縮んで図解になります。街・文字・街・図解と変えて、飽きさせないようにしています
- 締めのカルーセルと5人の声:最後は5人のカードが回り、「詳しくはリンクから」の声は、東京の男性の声のタイミングにほかの4人の声を合わせて重ねました
AIの人物で広告を作るときに、決めていること
Masayume が決めていることが1つあります。AIの人物には、架空の実績を言わせません。5人が話しているのは「Masayume は」という話で、数字は本物の画面で見せています。広告の最後にも「出演者はすべてAIで作成しています」と入れています。
「AIとバレない」というのは、だますことではありません。AIっぽさで見るのをやめられないようにすること、見る人を最後まで連れていけるかどうかが勝負だと、Masayume は考えています。
よくある質問
英語のプロンプトが書けなくても作れますか?
作れます。この動画では、三面図・合成・動画のプロンプトをすべて Claude に書いてもらっています。三面図の形を書いたテンプレートを先に渡しておくと、「パリの女性の三面図を作って」のような一言で、毎回同じ形のプロンプトが返ってきます。
三面図に、正面の全身は入れない方がいいですか?
入れて大丈夫です。問題は正面ではなく、三面図の中に顔が2つ以上あることです。顔は左のパネルだけにして、真ん中と右の体のパネルは首から下で切ります。1回目は頭が入りやすいので、出したらすぐに点検します。
声は、別に作った声を渡す方がきれいですか?
1人15秒の1本なら、Seedance 2.5 にそのまま話させる方がきれいでした。声を参照で渡しても、Seedance が作り直したためです。そのかわり、台本にない言葉を足すことがあるので、セリフは秒と読み方まで書き、余分な言葉は編集で切ります。
まとめ
- ルール1:顔は1か所。三面図は左が顔、真ん中と右は首から下
- ルール2:場所と光を先に決める。街と光の向きを決め、人物と合成した開始フレームから動かす
- ルール3:動きと声は言葉で作る。セリフは秒と読み方まで書き、手を動かすキーワードも書く
- 応用:何人もそろえるなら、顔の位置をそろえ、灰色の人形で構図とタイミングを渡す
- 出す・点検する・直す。1回で決まらないのが普通です
次にやることは1つです。電車の中の広告や駅の大きな画面を見るたびに、「これはAIで作れるか」を考えてみてください。作れそう、と思えたものが最初の1本です。動画で使った三面図のプロンプトのテンプレートは、公式LINE で「三面図」と送ると届きます。
Claude と Higgsfield をつないで広告の動画を作る流れは、ClaudeとHiggsfieldをMCPで連携して広告動画を作る4ステップ でも紹介しています。公開中の記事は 記事の一覧 にまとめています。
AI で動画づくりを効率化したい方へ
Masayume が実際に使っている自動編集の進め方は、「Masayume式 自動編集スターターキット」にまとめています。AEなしで、YouTube の長尺の1本目を公開するまでの7日間です。キットの内容を見る
社内で動画づくりを回したい法人の方は、法人向けのご案内 をご覧ください。